

 8 /342

社群媒體中顧客知識之挖掘:意見探勘技術開發
8
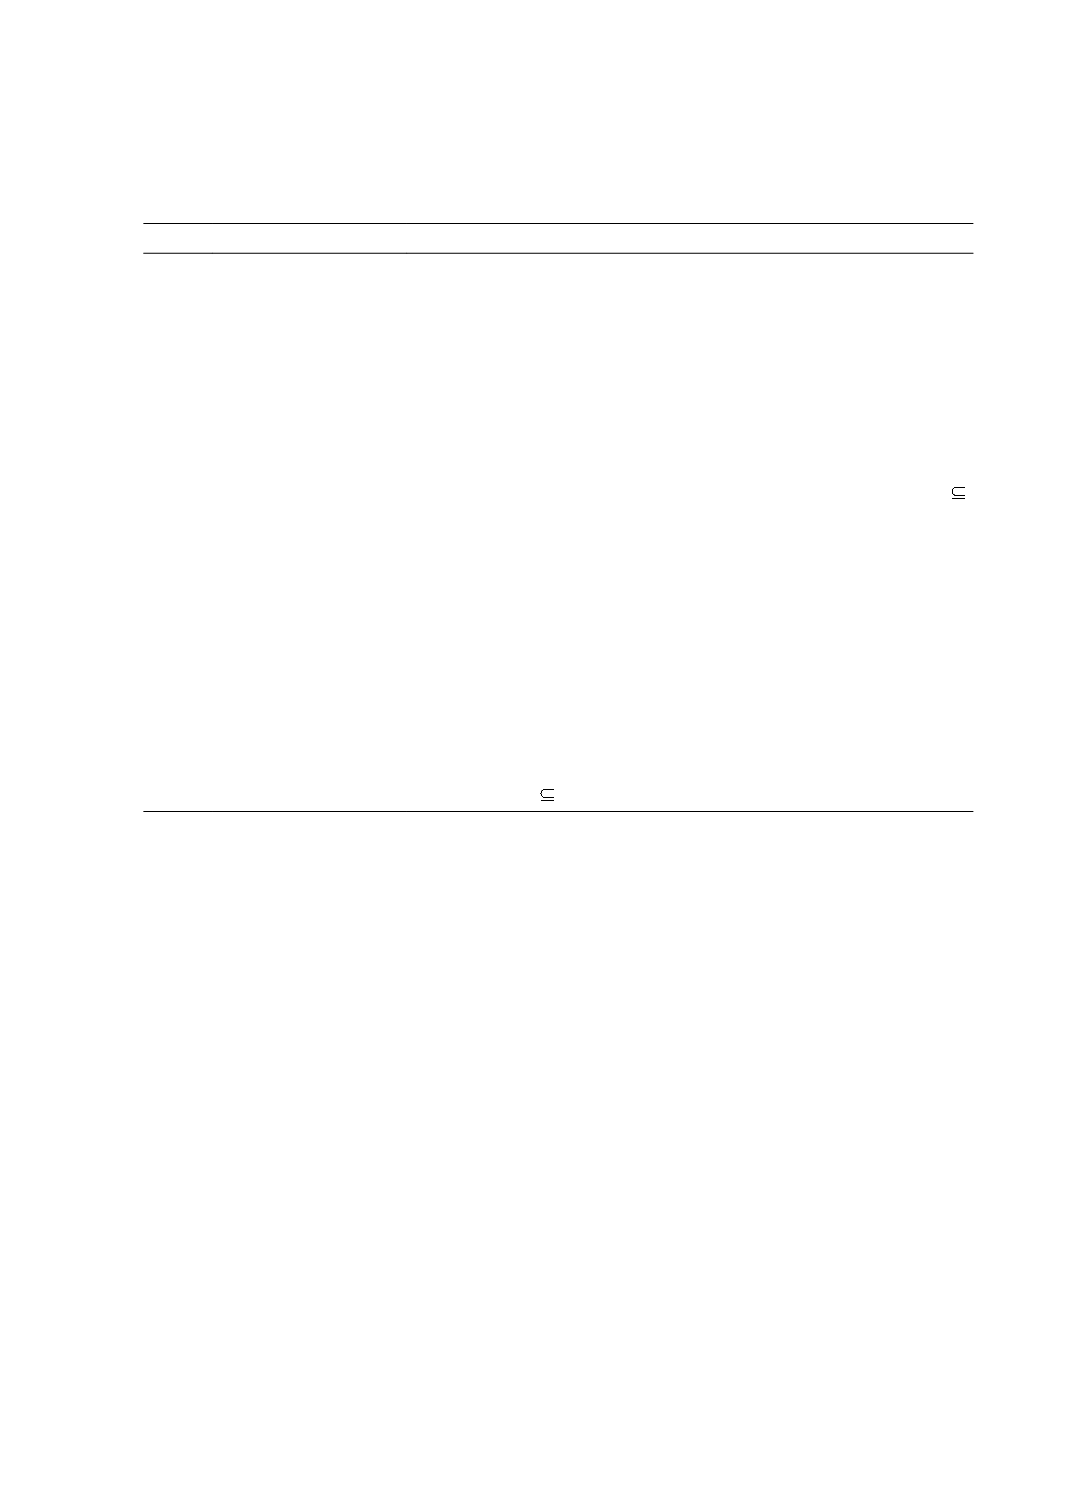
表
1
相關變數意義
變數 中文名稱
意義
f
j
產品特徵
使用者感興趣的產品特徵,例如「電池」。一個產品可以有多項感興
趣的產品特徵。
SMC
社群媒體文集
Social Media Corpus
的縮寫,為一組自社群媒體爬取,且未經標註的
使用者產生資料,用於產品特徵識別規則學習。
Q
j
產品特徵關鍵字
一組描述產品特徵
f
j
的關鍵字集合,例如,使用「「電池」、「充電」、
「鋰」、「鎳氫」」等關鍵字來描述產品特徵「電池」。
Q
j
可由一個
或多個關鍵字組成。
s
i
句子
社群媒體文集或其他使用者產生資料中的任一句子。
COS
j
候選意見句子集
社群媒體文集中,包含
Q
j
裡任一關鍵字的所有句子的集合。
(
COS
j
SMC
)
W
i
有意義字詞集合
句子
s
i
在經過前處理步驟(包含詞性標註、詞幹還原、有意義字詞選
擇)後的字詞集合。
w
k
為
W
i
集合中的任一字詞。
PFIR
j
產品特徵識別規則集合
Product Feature Identification Rules
的縮寫,為類別關聯規則演算法
分析後的結果,一組可用來識別產品特徵
f
j
的規則。
UGC
使用者產生資料文集
User Generated Content Corpus
的縮寫,為系統真正要進行情感分
析的目標文集,類似
Machine Learning
中的測試資料集。
UGC
與
SMC
同樣都是自社群媒體爬取來的使用者產生資料,其交集可是空集
合或非空集合。
OS
j
意見句子集
Opinion Sentences
的縮寫,為
UGC
中系統判斷有討論產品特徵
f
j
的
句子集合。
(
OS
j
UGC
)
一、產品特徵識別規則學習
產品特徵識別規則學習階段的目的在利用使用者提供的少量產品特徵
f
j
描述,搭
配網際網路上擷取的未經標註的社群媒體文集,進行半監督式的學習,產生可以用來
識別句子是否討論產品特徵
f
j
的類別關聯規則。本階段主要有四個步驟,分別為網頁
爬行
(Web Crawling)
、候選意見句子檢索
(Candidate Opinion Sentence Retrieval)
、前處
理
(Preprocessing)
與規則學習
(Rule Learning)
。
(一)網頁爬行
為進行社群媒體的分析,首先得要撰寫網頁爬行器
(Web Crawler)
,去抓取社群媒
體上的使用者產生資料,形成社群媒體文集
(SMC)
,以供後續分析之用。本研究自行
撰寫網頁爬行器,根據研究主題的不同,至適當的網站,抓取相關主題的使用者評論,
作為社群媒體文集。此外,會先去除社群媒體文集中無意義的資料(例如,
html
標籤、
廣告、無關外部連結等),並進行斷句,以句子作為文集中資料儲存與分析的單位。
(二)候選意見句子檢索
社群媒體文集
SMC
中的句子可能討論各式各樣的產品特徵(例如,手機的電池、
螢幕、價格⋯等),也可能是客觀的描述,因此要建構特定產品特徵
f
j
(例如,「電池」)